Apprendimento lazy e metodo dei nearest neighbors
Lazy learning
Section titled “Lazy learning”Esempio: riconoscimento di cifre scritte a mano.
Si parte da un database KV, dove le chiavi sono l’immagine di una cifra e i valori sono il numero corrispondente.
Metodo non generale: ricevuta un’immagine, la si cerca nel database e si ottiene il risultato. Se un’immagine è nuova il sistema non funziona, a noi serve un metodo che sia in grado di riconoscere anche nuove immagini.
Nearest neighbors method
Section titled “Nearest neighbors method”Questo diagramma mostra la distribuzione di funghi edibili e velenosi in base alle dimensioni:
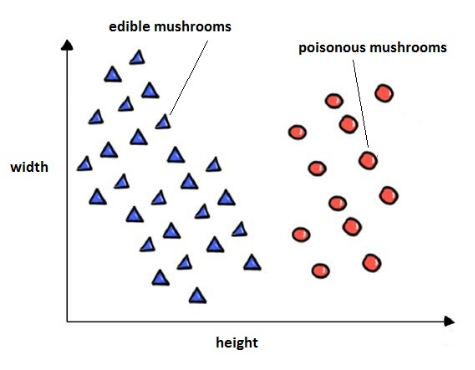
Quando si osserva un nuovo fungo, si può definire se esso è edibile o no copiando il valore del fungo con le dimensioni più vicine.
Nonostante la semplicità, il metodo nearest neighbors è accettabile quando:
- c’è un database molto grande di casi etichettati;
- è ben definita una misura di distanza tra gli elementi;
Perché neighbors e non neighbor?
Section titled “Perché neighbors e non neighbor?”Nel database sopra, le due categorie di funghi sono ben distinte. Nella realtà è possibile che ci sia un maggiore mescolamento tra i casi.
Di solito si parla di nearest neighbors perché presi i elementi più vicini, si sceglie il valore che (per esempio) appare più volte.