Reti neurali, perceptron MLP e backpropagation
Reti neurali
Section titled “Reti neurali”Il nostro cervello è composto da circa neuroni (unità computazionali) e sinapsi (connessioni).
Il neurone ha un funzionamento molto semplice: in base allo stimolo che riceve, è in grado di inviare o meno uno stimolo elettrico ai suoi vicini.
Sistemi complessi come il cervello umano si formano dall’interazione di un gran numero di unità semplici.
Architettura MLP (Multilayer Perceptron)
Section titled “Architettura MLP (Multilayer Perceptron)”Il neurone artificiale (detto perceptron) è riprodotto con 2 operazioni matematiche in sequenza:
- prodotto scalare ;
- funzione sigmoidale;
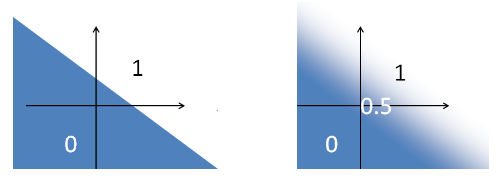
In questo modo abbiamo creato una funzione in grado di dividere uno spazio in 2 a seconda dell’input dato:
- a sinistra si vede lo spazio diviso usando solo il prodotto scalare;
- a destra è stata applicata la funzione sigmoidale;
Funzione sigmoidale
Section titled “Funzione sigmoidale”La funzione sigmoidale imita il comportamento di un neurone naturale: il segnale che esso invia cresce gradualmente tra l’intensità minima e la massima.
Essa fa parte di una famiglia di funzioni non lineari dette funzioni di squashing. Queste funzioni sono limitate superiormente e inferiormente. Quella usata più comunemente è:
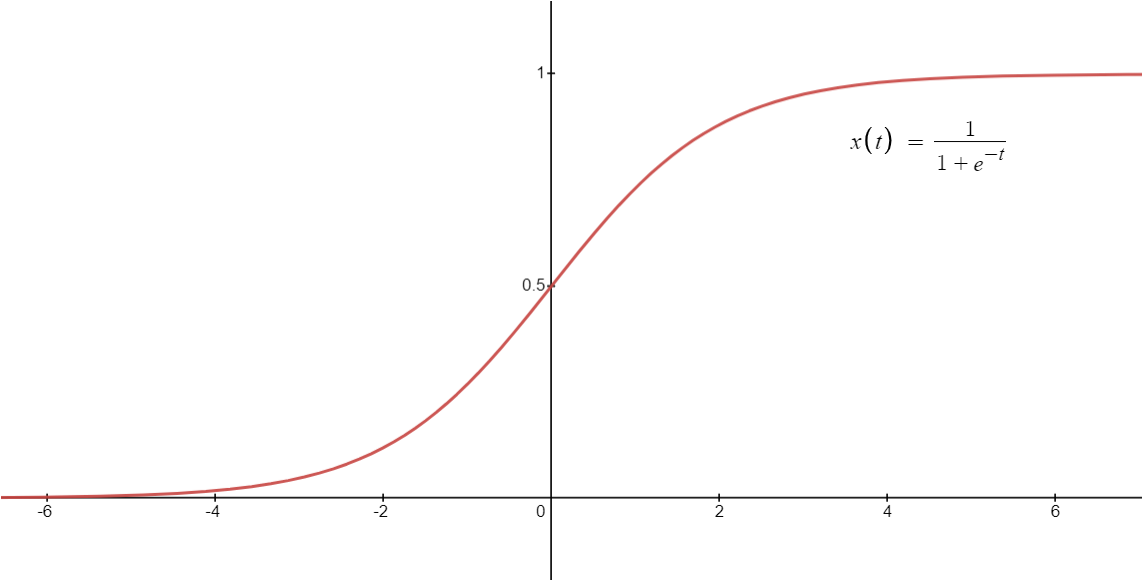
Applicando la funzione sigmoidale, si può far rientrare l’output del prodotto scalare in un intervallo . L’output della funzione può essere interpretato come una probabilità.
Strati
Section titled “Strati”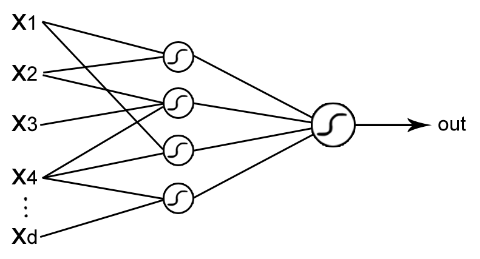
Gli MLP sono composti da un gran numero di unità parallele interconnesse, organizzate in strati. L’output di uno strato diventa l’input dello strato successivo.
In un modello con almeno uno strato nascosto (né di input né di output), si può ottenere un modello flessibile capace di approssimare qualsiasi funzione .
Backpropagation
Section titled “Backpropagation”- Si prende una funzione di errore da ottimizzare (come la somma degli errori quadrati vista in precedenza ()).
- Si usa il gradient descent per trovare il valore ottimale dei pesi.
La backpropagation è l’operazione di calcolo del gradiente della funzione di errore rispetto ai pesi; il gradient descent usa il gradiente calcolato per spostare i pesi di un piccolo passo verso il punto di minimo.
Dato che il nostro modello è una composizione di funzioni, si deve usare la regola della catena per trovare il gradiente.
Come non incastrarsi nei minimi locali?
Section titled “Come non incastrarsi nei minimi locali?”È un problema non ancora risolto; i risultati sul campo dimostrano però che è possibile allenare modelli affidabili anche quando la discesa si ferma su punti di minimo locale.