Modelli lineari, regressione e pseudoinversa
Modelli lineari
Section titled “Modelli lineari”I modelli lineari servono a generalizzare problemi in cui la relazione tra il cambiamento di valore dell’input e l’output può essere trovata attraverso la soluzione di un sistema lineare.
Ciò li rende molto semplici sia da addestrare che da capire, basta analizzare i parametri per capire quali sono quelli che maggiormente influenzano il risultato.
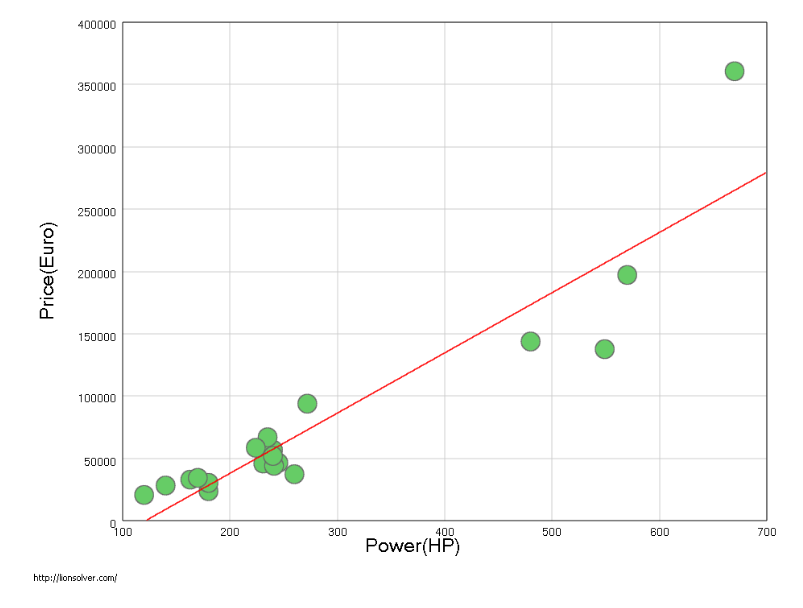
Esempio: si può generalizzare la relazione tra la potenza e il costo di un’automobile:
Regressione lineare
Section titled “Regressione lineare”In un modello lineare, ogni componente di è moltiplicata da un parametro . Possiamo generalizzare e scrivere che il risultato è dato dal prodotto scalare tra la matrice trasposta dei parametri e il vettore input.
Tecniche di approssimazione non lineare
Section titled “Tecniche di approssimazione non lineare”La prima restrizione che incontriamo usando la definita sopra è che si assume che .
Per risolvere il problema basta aggiungere una dimensione fittizia al vettore in input e poi fissare la nuova componente a 1.
Questi modelli vengono detti affini.
In questo caso sarà la funzione lineare e la funzione affine:
Questo permette di modellare relazioni che non passano per l’origine, pur continuando a usare l’approssimazione della retta che minimizza la somma degli errori quadratici.
Per usare l’algebra lineare per ottimizzare è necessario che il modello sia lineare nei pesi, non nei dati in input. Infatti durante l’ottimizzazione la variabile da trovare è , mentre rimane costante.
Generalizzazione
Section titled “Generalizzazione”In pratica i dati di input possono essere processati a piacimento per estrarre più features.
Possiamo definire una funzione che applica trasformazioni arbitrarie al vettore di input (anche non lineari). Poi passeremo quel risultato in ingresso al nostro modello lineare:
Classificazione lineare
Section titled “Classificazione lineare”Nel caso della classificazione possiamo usare il risultato della regressione lineare come discriminante.
Il prodotto scalare tra i vettori e definisce un iperpiano di frontiera che divide lo spazio in due regioni: una dove il risultato è positivo e una dove è negativo. La frontiera è data dai vettori perpendicolari a .
Ottimizzazione attraverso la pseudo-inversa
Section titled “Ottimizzazione attraverso la pseudo-inversa”Come visto in precedenza, dobbiamo trovare il valore dei pesi in modo da minimizzare gli errori del modello:
Nel caso ideale, senza errori di misurazione sul dataset degli esempi, si potrebbero trovare i pesi attraverso un sistema di equazioni lineari, che si risolve invertendo la matrice dei coefficienti:
Nella realtà, purtroppo, ci sono sempre errori di misurazione. Quindi si ottiene un sistema sovradeterminato, in cui alcune equazioni risultano contraddittorie. Occorre quindi approssimare la soluzione che permetta di minimizzare anche se difficilmente si arriverà a .
Per fare ciò possiamo usare la pseudoinversa di , denotata con e definita come:
Noi dobbiamo risolvere, usando tutti gli esempi, il sistema di equazioni . Otteniamo quindi la seguente formula, in cui è la matrice che raccoglie tutti gli esempi di input e il vettore degli output corrispondenti: