Rappresentazioni, distanze e metodi di clustering
Rappresentazioni in clustering
Section titled “Rappresentazioni in clustering”- rappresentazione esterna: per ogni entità, l’informazione è data dalla relazione tra essa e un’altra.
- rappresentazione interna: ogni entità è identificata da un vettore di numeri.
Raggruppare vettori simili conoscendo la rappresentazione interna è molto facile, basta calcolare la distanza euclidea. Fanno eccezione i casi in cui l’input non può essere normalizzato.
Alcuni esempi di distanza:
Distanza euclidea:
Norma di Manhattan: distanza misurata solo muovendosi in verticale o in orizzontale:
Angolo del prodotto scalare:
Può essere utile normalizzare le componenti dei vettori quando si calcola la distanza euclidea, ad esempio dividendo ogni componente per il suo intervallo di variazione:
dove e sono i valori massimo e minimo della componente -esima nell’insieme di dati.
Queste misure di distanza, essendo basate sulle relazioni tra coppie di entità, costituiscono invece una rappresentazione esterna.
Hard e soft clustering
Section titled “Hard e soft clustering”- Hard clustering: gli insiemi di partizione sono disgiunti, l’obiettivo è quello di minimizzare le dissimilarità tra elementi dello stesso sottoinsieme e di massimizzare la distanza tra elementi di insiemi diversi.
- Soft clustering: l’appartenenza ad una certa classe è espressa da un numero, quindi i confini tra i sottoinsiemi si sovrappongono parzialmente.
K-means
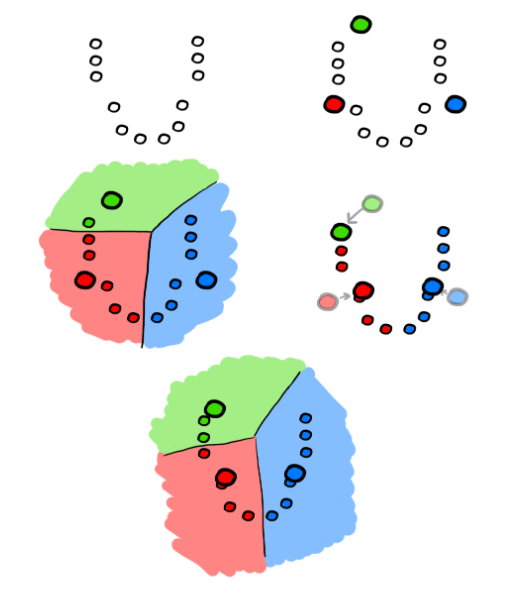
Section titled “K-means”L’algoritmo di k-means è un algoritmo partizionale: partiziona l’insieme di dati in sottoinsiemi disgiunti a partire da un insieme di prototipi iniziali.
Per ogni cluster, il prototipo (di solito la media delle componenti) viene calcolato minimizzando l’errore di quantizzazione.
- si sceglie il numero di cluster ();
- si generano in maniera casuale prototipi;
si ripete finché non viene soddisfatto un criterio di arresto:
- si assegna ogni punto al cluster il cui prototipo è più vicino;
- si sposta il prototipo nella posizione data dalla media dei punti che gli appartengono;
Soft clustering
Section titled “Soft clustering”In alcuni casi, l’assegnamento di un’entità ad un cluster non è netto ma dipende da una probabilità:
Il valore di appartenenza ad un certo cluster può essere dato da:
L’aggiornamento dei centroidi può essere eseguito in modo leggermente diverso. Il centroide viene ‘tirato’ da ogni entità di una distanza proporzionale al grado di membership e alla learning rate . Il contributo di una singola entità è:
Ci sono due versioni leggermente differenti:
- online update: ogni volta che si osserva un’entità, si sposta immediatamente il centroide;
- batch update: prima si trovano tutte le entità appartenenti al cluster, poi si sposta il centroide con la somma di tutti i contributi;