Learning rate, backpropagation e reti profonde
Learning rate
Section titled “Learning rate”Quando ci spostiamo durante la discesa del gradiente, come stabiliamo di quanto spostarci?
- se ci muoviamo di troppo, rischiamo di ‘saltare’ il punto di minimo;
- se ci muoviamo troppo poco, l’apprendimento richiederà troppo tempo;
Bold driver backpropagation
Section titled “Bold driver backpropagation”- Se gli step successivi fanno diminuire , possiamo aumentare esponenzialmente lo spostamento.
- La prima volta che il valore di sale anziché scendere, ridurremo rapidamente la velocità.
On-line or stochastic backpropagation
Section titled “On-line or stochastic backpropagation”è una somma degli errori su tutti gli esempi. Di conseguenza, anche il gradiente è una somma dei corrispondenti gradienti di ogni esempio.
Invece di calcolare la somma di tutti i gradienti, ogni volta che prendiamo un esempio , preso casualmente dal training set, ne calcoliamo il gradiente e facciamo un piccolo step () verso il minimo:
Questo rende l’operazione di training altamente parallelizzabile anche se si perde un po’ di precisione.
Reti neurali profonde
Section titled “Reti neurali profonde”Mappare degli input a degli output risulta molto più facile se il modello contiene più layers nascosti. L’ideale sarebbe che il MLP crei automaticamente delle rappresentazioni interne (codificate come valori di attivazione di ogni layer).
Il problema sta nel calcolo delle derivate dell’errore. La regola della catena porta le derivate dei primi strati ad avere valori molto piccoli (che il computer approssima a 0). Quindi i pesi nei primi strati resterebbero al loro valore casuale iniziale, rendendoli inutili.
Auto-encoders
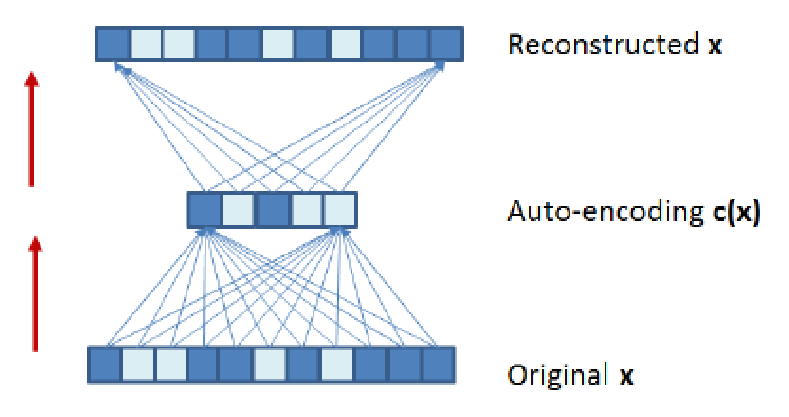
Section titled “Auto-encoders”Gli auto-encoders permettono di costruire rappresentazioni interne degli esempi in maniera non supervisionata.
Quando costruiamo una rete a strati, chiediamo che il modello, dato un input, riproduca semplicemente quell’input come suo output. In questo modo non c’è bisogno di avere un sistema che deve etichettare in maniera corretta gli esempi.
Se la rete ha un collo di bottiglia, ovvero contiene strati interni con meno variabili di quelle dello strato di input, allora sarà forzata a trovare delle regolarità nei dati di esempio.
Questo tipo di modelli sta alla base di quasi tutti i modelli in grado di generare immagini.
Regressione con reti neurali non supervisionate
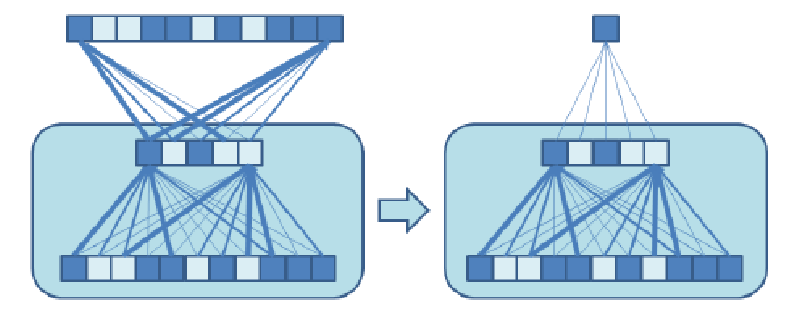
Section titled “Regressione con reti neurali non supervisionate”Se rimuoviamo la parte superiore del modello visto sopra, possiamo ricombinare le attivazioni interne, calcolate con i pesi appresi e utili per il riconoscimento (senza modificarli), per ottenere un singolo numero in output.