Ridge regression, alberi di decisione e foreste
Instabilità nei modelli lineari
Section titled “Instabilità nei modelli lineari”Un modello è detto stabile quando piccoli errori di misura sull’input o errori di arrotondamento sui calcoli eseguiti dal computer influenzano in maniera negligibile il risultato.
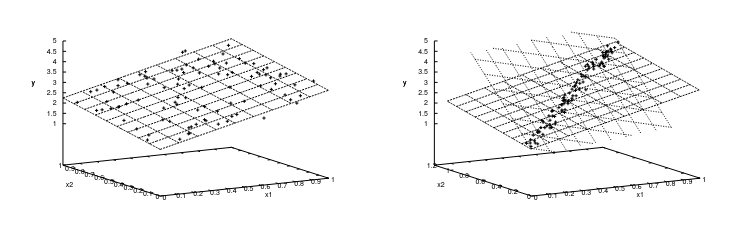
Il primo modo per rendere un modello più stabile è quello di ottenere dati migliori. Nei grafici qui sotto:
- il primo insieme è ben distribuito, quindi lo spostamento di alcuni punti (valori degli esempi nel training set) non genera variazioni nell’inclinazione del piano (che può rappresentare un divisore tra le due classi per la classificazione);
- il secondo insieme rende il modello molto sensibile a piccoli cambiamenti nei valori degli esempi;
Il secondo modo, quando non c’è possibilità di modificare gli esempi, è quello di utilizzare la ridge regression, ovvero l’aggiunta di un termine di regolarizzazione alla funzione di errore.
Quando si inserisce un piccolo termine diagonale () nella pseudoinversa, l’operazione di inversione diventa molto meno sensibile agli errori di calcolo del computer:
Per minimizzare rispetto a si usa la seguente espressione:
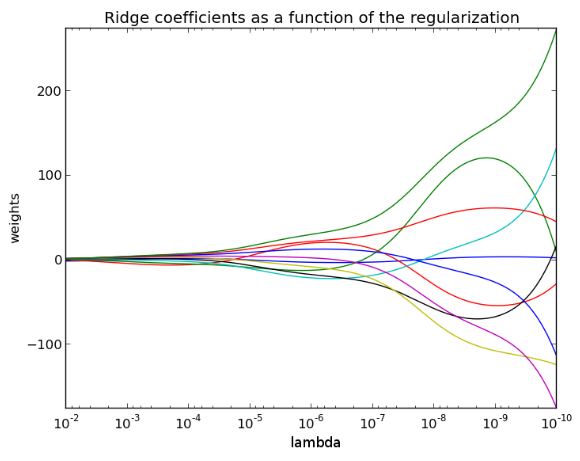
Il valore di può essere ottenuto provandone diversi sul validation set tenendo quello che dà i risultati migliori. Nell’immagine qui sotto si vede come un troppo grande fa perdere significato ai pesi.
Regole decisionali
Section titled “Regole decisionali”Negli anni ‘70 si era cercato di sviluppare sistemi di intelligenza artificiale basati su regole: il risultato era deterministico, perché per ogni causa era definito un effetto.
Una regola è un piccolo ‘pezzo’ di conoscenza, che talvolta può essere espresso mediante il linguaggio umano.
Problemi:
- le regole devono essere scritte a mano;
- quando il numero di regole cresce, è possibile introdurre regole contraddittorie;
Regole complesse devono essere spezzate in una catena di regole più semplici unite da un AND. In questa catena dobbiamo mettere le regole più informative all’inizio.
Se si organizzano le regole sotto forma di albero, si può creare una gerarchia senza contraddizioni.
Alberi di decisione
Section titled “Alberi di decisione”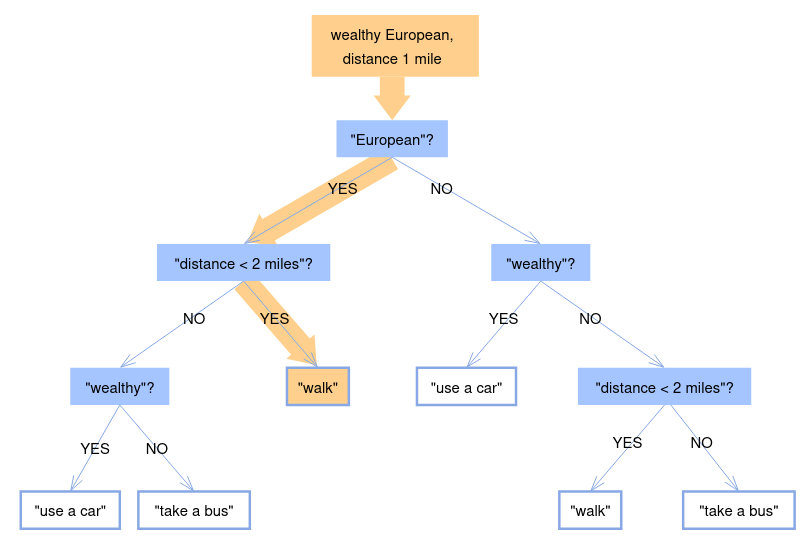
Un albero di decisione è un insieme di domande, organizzate in maniera gerarchica, con un sotto-albero per ogni risposta che può ricevere una specifica domanda.
La costruzione di un albero è un processo ricorsivo: basta prendere una domanda e dividere il training set a seconda della risposta; poi per ogni ramo si ripete il processo passando alla domanda successiva.
Il problema che resta è quello di determinare qual è la domanda più informativa da usare all’inizio.
Durante il training le domande ‘finali’ sono quelle dove tutte le risposte (o una gran parte di esse) del sottoinsieme cadono in un solo ramo. A quel punto non ha più senso continuare il processo e si può restituire un output all’utente.
Le domande che classificano un alto numero di esempi in un ramo rispetto agli altri sono dette più pure rispetto alle altre. Le domande più informative sono quelle che purificano maggiormente l’input.
Misura quantitativa della purezza
Section titled “Misura quantitativa della purezza”La purezza può essere misurata in due modi:
Guadagno informativo (information gain):
Preso un campione del set di training associato al nodo (ovvero la domanda) dell’albero, per ogni elemento dell’insieme ci sarà una probabilità che esso appartenga ad una certa classe (ovvero dia una certa risposta).
Incertezza o entropia di Shannon: l’incertezza su tutte le possibili classi è data dalla formula:
L’entropia misura l’impurità dell’insieme. È massima () quando le classi hanno la stessa probabilità, e minima () quando tutti i casi appartengono ad una sola classe.
Il guadagno informativo di un nodo dell’albero allenato con un insieme di esempi è dato dalla seguente formula:
Se la risposta ad una domanda fa guadagnare più informazioni, l’entropia generale dell’albero diminuirà.
Impurità di Gini:
Si prende un input e gli si assegna una risposta tra quelle dei rami, con una percentuale data dalla distribuzione delle risposte del set di training sui vari rami del nodo.
L’impurità di Gini misura quanto spesso la risposta casuale assegnata è sbagliata rispetto a quella attesa.
Essa raggiunge il minimo quando tutti i casi in un nodo cadono in un’unica classe.
Come gestire i valori mancanti
Section titled “Come gestire i valori mancanti”Spesso l’input dato all’albero non contiene tutti i dati necessari per dare una risposta.
Quando si arriva a un nodo per cui non si può rispondere, si può usare la seguente tecnica:
- si suddivide (virtualmente) la risposta tra tutti i rami, con una percentuale data dal numero di esempi caduti in ognuno di essi;
- si calcola la risposta per ogni sotto-albero;
- poi è possibile prendere una media pesata tra le risposte di ogni ramo;
Foreste di alberi
Section titled “Foreste di alberi”Spesso durante il training, a causa della casualità introdotta nel processo, si ottengono diversi alberi validi, che daranno risposte leggermente diverse.
In questo caso si può prendere la media delle risposte di tutti gli alberi.
Sperimentalmente si è visto che questa tecnica migliora di molto le prestazioni di un sistema, rispetto a un sistema che usa un singolo albero.