Clustering agglomerativo e distanza di Mahalanobis
Bottom-up: agglomerative clustering
Section titled “Bottom-up: agglomerative clustering”Nel clustering agglomerativo, si parte da piccoli sottoinsiemi e ad ogni ciclo si uniscono quelli più simili.
Anche in questo caso si richiede di stabilire una misura di distanza tra 2 gruppi. Ci sono 3 scelte principali, che funzionano bene a seconda della tipologia di input: distanza media tra i punti, distanza minima e distanza massima.
Algoritmo di merging
Section titled “Algoritmo di merging”Dato un insieme di clusters :
- Prendi i clusters e con la distanza minima tra loro;
- Sostituisci e con la loro unione, registra la distanza tra i 2 insiemi, e ripeti;
Dendrogramma
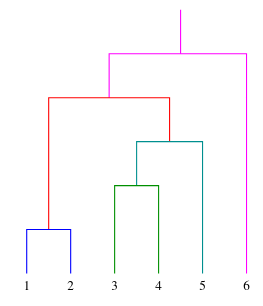
Section titled “Dendrogramma”L’algoritmo può essere visualizzato attraverso un albero, dove le foglie sono i punti iniziali e la radice è l’insieme totale degli input.
L’altezza di ogni nodo è data dalla distanza tra i 2 rami (sottoinsiemi), cioè la registrata in precedenza.
Il punto in cui si vuole tagliare orizzontalmente l’albero determina dove fermare l’algoritmo.
Distanza di Mahalanobis
Section titled “Distanza di Mahalanobis”Per una distribuzione sferica simmetrica rispetto agli assi:
- si calcola la media dei punti;
- si calcola la deviazione standard delle distanze dei punti dalla media;
- per ogni punto: ;
Questa procedura basta quando la distribuzione è sferica, cioè quando le componenti dei punti sono incorrelate e hanno la stessa varianza lungo ogni direzione. Se la distribuzione non è sferica, però, la semplice standardizzazione non basta più: le componenti sono correlate e la dispersione dipende dalla direzione, quindi la distanza euclidea dalla media non riflette la vicinanza effettiva al cluster.
La distanza di Mahalanobis generalizza questa idea al caso non sferico: misura la distanza di un punto dalla media del cluster in unità di deviazione standard lungo le direzioni principali, come se lo spazio venisse trasformato in modo da rendere la distribuzione sferica. Per questo la matrice di covarianza compare al denominatore attraverso la sua inversa. La distanza di Mahalanobis di un vettore da un cluster di punti con media e matrice di covarianza è definita:
Self-organizing maps
Section titled “Self-organizing maps”Una mappa è una funzione che prende input n-dimensionali e li suddivide in celle (su una mappa bidimensionale) a seconda della distanza tra loro.
Con il passare del tempo, ogni neurone si specializza e lo stimolo di attivazione influisce sempre meno sui neuroni circostanti.
Le SOMs sono utili quando si vogliono visualizzare dati ad alta dimensionalità: proiettano gli input su una mappa bidimensionale preservando le relazioni di vicinanza, quindi punti simili finiscono in celle vicine. Vengono usate per:
- esplorazione di dati non etichettati, per individuare pattern nascosti e gruppi di punti simili in modo non supervisionato;
- riduzione dimensionale, poiché rappresentano dati n-dimensionali su una griglia a 2 dimensioni;
- visualizzazione dei risultati del clustering, mostrando quali regioni della mappa corrispondono a classi o cluster diversi;
- rilevamento di anomalie: un punto che non si avvicina a nessun neurone specializzato è probabilmente un outlier.