Varietà e selezione delle feature nei modelli
Varietà
Section titled “Varietà”In geometria, una varietà è uno spazio che localmente è simile ad uno spazio euclideo, ma che globalmente può avere proprietà diverse.
In una varietà è possibile interpolare linearmente due punti vicini.
Feature selection
Section titled “Feature selection”Nel mondo reale, i dati che usiamo per allenare un modello possono essere duplicati, irrilevanti o mancanti.
Bisogna quindi prendere un sottoinsieme delle features per ottenere i seguenti vantaggi:
- riduzione di dimensionalità;
- riduzione dell’utilizzo di memoria;
- miglior generalizzazione;
- maggiori possibilità di spiegare come funziona il modello, grazie al minor numero di dimensioni;
Il processo di feature selection non ha una soluzione unica: serve molto intuito e conoscenza del dominio. Ci sono però tre tipi di metodi efficaci:
Wrapper methods: Si testa ogni combinazione di features del training set, poi si tiene quella che dà l’errore minore.
Per disabilitare una feature, si moltiplica il vettore di input per un vettore le cui componenti sono 0 (feature disabilitata) o 1 (feature abilitata).
Quindi, dato un input a dimensioni, si hanno possibili combinazioni di features.
Filter methods: Al posto di usare l’errore, che richiede il training di molti modelli diversi (costoso), si possono provare a usare altri indici che predicono quanto una variabile potrebbe influire sul risultato finale. Alcuni esempi sono la correlazione e l’informazione mutua tra due variabili.
Embedded methods: Le features vengono selezionate durante il training, portando a 0 i pesi di quelle che si vuole disabilitare.
Ci sono due modi di procedere per scegliere le features:
- bottom-up: si inseriscono features in ordine di importanza fino a quando l’errore non smette di scendere;
- top-down: si eliminano progressivamente features fino a quando si ottengono le performance migliori (sia di errore, sia di grandezza del modello);
Metodi di selezione
Section titled “Metodi di selezione”Valore dei pesi
Section titled “Valore dei pesi”Il metodo più intuitivo per definire l’importanza di una feature potrebbe essere quello di osservare il valore del suo peso e tenere solo quelli più significativi.
Inoltre ci sono features che non hanno nessun valore quando vengono prese da sole. Però la presenza di altri input può cambiare il risultato (si pensi a situazioni simili ad un XOR logico).
Coefficiente di correlazione
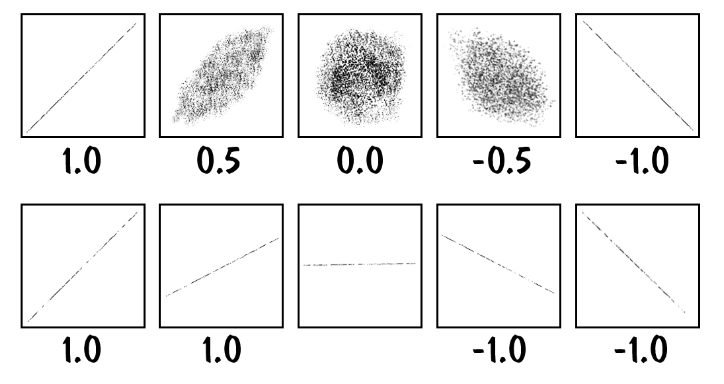
Section titled “Coefficiente di correlazione”Per misurare relazioni di tipo lineare (che formano una retta su uno scatter plot) tra due variabili, si usa il coefficiente di correlazione di Pearson:
Per due variabili altamente correlate (valore vicino a o ), la conoscenza di ci dice quale sarà il valore di . Quindi quella feature ha alta influenza sul valore del risultato e perciò non va scartata.
Anche se una feature ha correlazione , non è detto che non contenga informazioni sull’output: la loro relazione potrebbe infatti essere di tipo non lineare.