Throughput, fairness e algoritmi TCP moderni
Throughput teorico di TCP
Section titled “Throughput teorico di TCP”Una formula approssimata per calcolare il throughput di una connessione TCP è:
dove:
- è la probabilità di perdere un pacchetto;
- è il maximum segment size;
- è il round-trip time.
Problemi di equità (fairness) in TCP
Section titled “Problemi di equità (fairness) in TCP”Le applicazioni UDP non riducono il proprio ritmo di trasmissione in caso di congestione, mentre il TCP si adatta alla banda disponibile. Ci sono 2 conseguenze:
- se un’applicazione apre più connessioni in una rete esclusivamente TCP, allora essa ottiene una frazione maggiore della capacità di rete rispetto ad un’altra che usa una singola connessione.
- se una connessione TCP e una UDP coesistono, allora quella TCP manterrà un throughput molto basso perché la rete viene congestionata dall’UDP.
Versioni più avanzate di TCP
Section titled “Versioni più avanzate di TCP”La versione di TCP vista finora (NewReno) è loss-based. Quindi il protocollo si aspetta una perdita di segmenti prima di reagire con il congestion control.
In realtà, nel tempo si è scoperto che la connessione TCP funziona meglio quando non si arriva al punto in cui si verificano le perdite di pacchetti, ma si rimane appena al di sotto della soglia di congestione del percorso di rete. Quindi i nuovi algoritmi cercano di mantenere il round-trip time il più basso possibile.
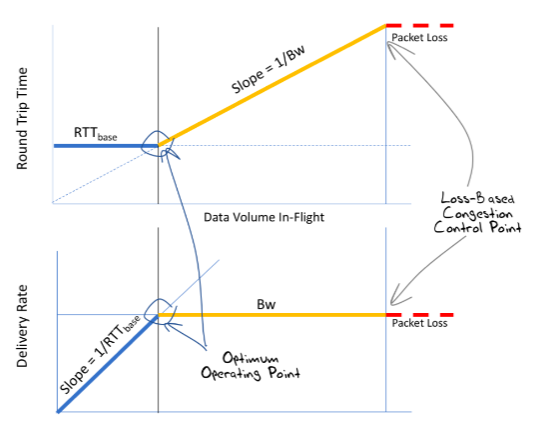
I protocolli di congestion control non richiedono la compatibilità da parte di entrambi gli host, dato che ogni host gestisce da sé come non congestionare la rete con i propri dati.
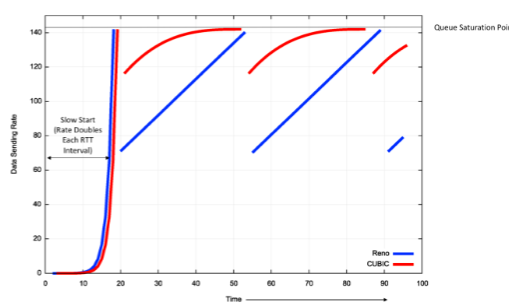
CUBIC è un algoritmo di controllo della congestione in TCP che fa variare la lunghezza della finestra di congestione secondo una funzione cubica nel tempo. Questo migliora la scalabilità e la stabilità su reti veloci e a lunga distanza.
A differenza di NewReno, CUBIC usa la parte concava della funzione cubica per avvicinarsi al valore massimo della finestra raggiunto prima della congestione, e la parte convessa quando lo supera per sondare se la rete supporta una banda maggiore.
dove , e .
Dopo una congestione, la finestra viene ridotta di un fattore .
BBR è un altro algoritmo di controllo della congestione in TCP, sviluppato da Google nel 2016. Non si basa sulla rilevazione di perdite di pacchetti ma stima 2 parametri:
- la banda massima disponibile sul percorso tra i 2 host;
- il round-trip time minimo;
Pacing: invece di inviare tutti i pacchetti consentiti dalla rete, i pacchetti vengono trasmessi al ritmo al quale può inviarli il nodo più lento (lungo il percorso di rete), in modo da evitare ritardi dovuti all’accodamento.
Ci sono 4 fasi:
- STARTUP: si cerca il punto in cui la banda è massima sulla rete aumentando esponenzialmente i dati trasmessi.
- DRAIN: quando si è superato il punto massimo, si ritorna ad esso per non congestionare la rete.
- PROBE_BW: periodicamente si supera di nuovo il punto massimo per vedere se è cambiata la rete, altrimenti si esegue nuovamente un DRAIN.
- PROBE_RTT: periodicamente si ricomincia da capo per lasciare spazio anche agli altri host (meccanismo di fairness) e per riportare il RTT al minimo (riduce i ritardi di accodamento).
QUIC è un altro protocollo progettato da Google nel 2012. Esso utilizza UDP per ridurre i 2 principali problemi di TCP: l’head of line blocking (un segmento perso su uno stream non blocca gli altri stream) e la latenza (grazie a un handshake più rapido).
Per ora QUIC viene implementato a livello applicativo, anziché nel kernel. Viene usato soprattutto dai browser moderni dato che sta anche alla base di HTTP/3.
Nel protocollo è stato incorporato lo scambio di chiavi del TLS, riducendo ulteriormente il numero di messaggi scambiati prima che la connessione sia utilizzabile.
A differenza di TCP, che identifica la connessione tramite la quadrupla formata da indirizzo e porta di sorgente e di destinazione, QUIC include un ID di connessione, quindi anche cambiando l’indirizzo IP del trasmettitore (che succede spesso con le reti wireless) non è necessario re-inizializzare la connessione.